结论先行
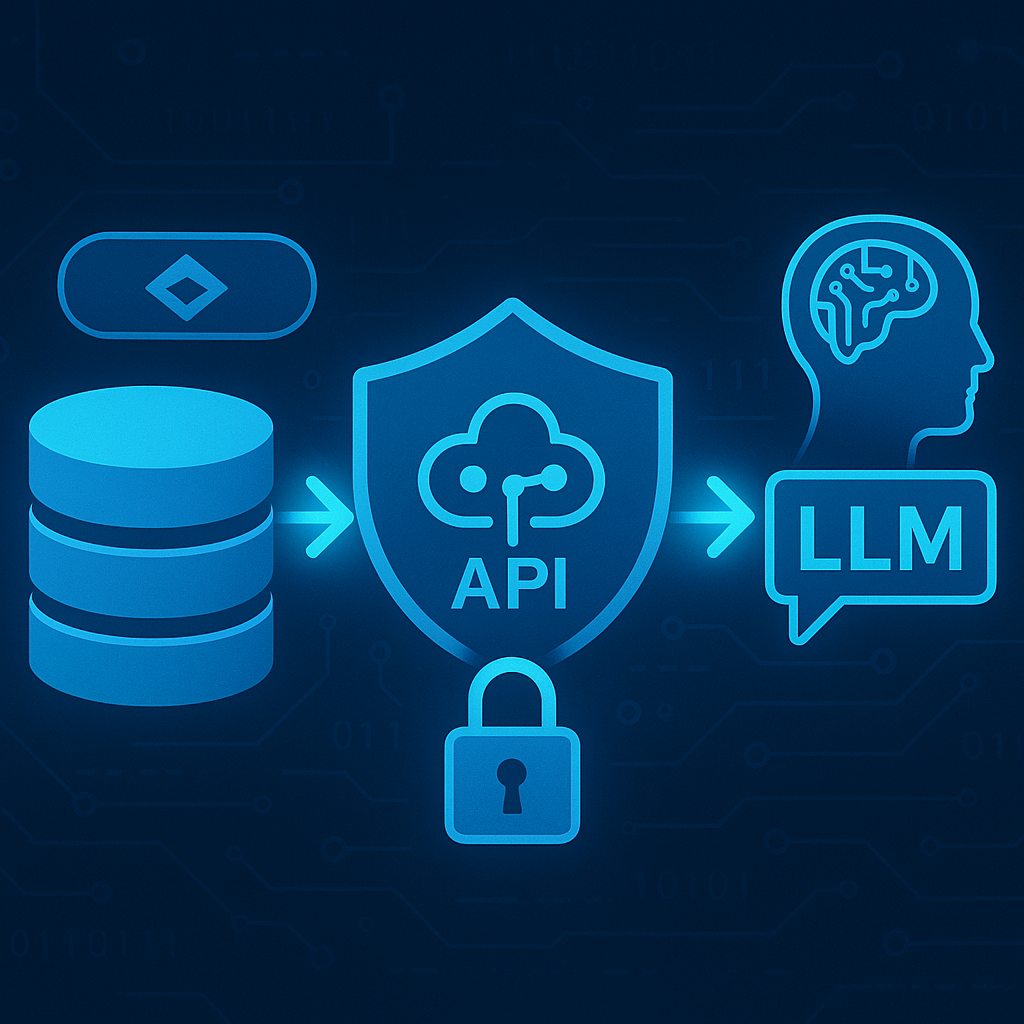
"把工具接上"这件事,行业已经标准化了一半。现在有一条现成的路:把工具做成 MCP server,客户端把工具清单递给模型,模型提出调用,客户端把调用发回 server。传输怎么走、工具叫什么名字、参数怎么序列化、返回怎么塞回上下文,这一整段有协议管着,不需要自己设计。
但一次工具调用,实际要走的路比这长。它可以拆成五段:传输 → 服务(查到工具)→ 参数校验 → 执行 → 回滚。MCP 管住的是前两段。后面三段——参数对不对、执行炸了怎么办、改了一半的动作谁来撤销——协议一个字都没有替你答应。它只是没有阻止你去写,而绝大多数接法也确实没写。
这不是猜测,作者写了一个台架把它量了出来:同一个工具服务,只换"接法"这一个变量,六组故障各跑一遍。
naive 线(不校验、不设超时、不分类、不补偿):6/6 组故障,没有任何一段接住。调用要么是"成功了但你不知道它是错的",要么是一个原生 Python 异常直接冲出链路。
guarded 线(五段各加一道判断):6/6 组都拦在对应的那一段,报错文本里能定位到段名、工具名、字段名或那个坏值。
拦得越早越便宜,这是可量的。参数类型错那一组,guard 在第 2 段就拦下;naive 一路走到第 4 段——工具已经真跑起来了——才炸。静默截断是最贵的一种:同一个返回 20000 字的工具,naive 给了 2000 字,没有任何标记;guard 给 2025 字,末尾写着"已截断:共 20000 字"。
原理:为什么"接上"和"负责"是两件事
先把归因说清楚,不然后面全是经验之谈。
第一,工具不是代码的一部分,它是链路上的一跳。本地写一个函数,调用它要么返回要么抛异常,栈里都看得到。工具不一样:它跨了进程、可能跨了机器、可能跨了网络,中间还有一层模型在替调用方决定"调哪个、带什么参数"。这中间任何一处出错,错误都不会自动长成熟悉的样子。
第二,协议能标准化的只有"形状",管不了"责任"。协议可以规定工具清单长什么样、调用怎么编码、返回怎么编码。它很难规定参数里的 lines 必须是整数,因为协议不知道业务里 lines 是什么;它很难规定超时该设几秒,因为协议不知道工具有多慢;它很难规定执行到一半挂了要不要撤销,因为协议不知道工具有没有副作用。这些只有知道业务的人才答得出来,而能答出来的那个人,是使用方自己。
第三,拦截点的位置决定了代价。同一个错误,在第 3 段被拦下和在执行完之后被发现,代价完全不同:前者损失的是"一次没必要的函数调用",后者损失的是"一次真跑了、可能改了状态的执行 + 一次人工回滚"。所以 schema 校验的位置不是风格问题,它是链路设计的一部分——校验必须在执行之前,不在结果之后。
第四,没有接住的失败,比报错更贵。一个调用失败了但没人报错,会以"成功"的形状流进下一步:以为拿到了摘要,其实拿到的是截断过的半份数据;以为那个文件写好了,其实写了一半。这类失败不会让人停下来,它会让人在更远的地方停下来。
五段各自的坏法
这五段是按工程直觉划的,不是协议里的分层。它是一张归因表:出问题的时候,能一眼指出该改哪一段,而不是笼统地说"工具不太好用"。
| 段 | 谁负责 | 典型坏法 | 拦在这里的代价 |
|---|---|---|---|
| 1 传输 | 协议 + 客户端 | 对方不回、回太慢、回来的东西不是要的格式 | 最低:什么业务动作都还没发生 |
| 2 服务 | 协议 + 使用方 | 工具名写错、版本对不上、清单里根本没有这个工具 | 低:只白跑了一次参数序列化 |
| 3 参数校验 | 使用方 | 类型不对、必填没给、枚举超范围、多传了字段 | 低:工具还没被调用 |
| 4 执行 | 使用方 | 抛异常、部分成功、返回被截断 | 高:副作用可能已经落地 |
| 5 回滚 | 使用方 | 没记"怎么撤销",于是只能人工收拾 | 最高:已经晚了,只能补救 |
看"谁负责"这一列就明白为什么说"MCP 只标准化了前两段":协议覆盖的、以及协议给接口但默认不做的,全在上面两行;下面三行的责任人栏写的都是"使用方"。
一个能跑的对照台架
脚本在仓库里,纯本地、确定性、不调模型,几秒钟跑完:
python3 tools/harness_lab/tool_chain_lab.py  # 全量:6 故障 × 2 线 + 阳性对照
python3 tools/harness_lab/tool_chain_lab.py --selftest # 只跑阳性对照,确认台架没坏
台架做的事很简单:同一个工具服务,包含 head、slow_head、dump、append_note 四个工具,接两条线。
naive 线就是一个正常开发者会写的接法:直接调,取不到工具就让它抛,参数不检查,没有超时,没有 try,不记补偿。代码里用 _wire 处理传输与查表,工具不在清单就抛 KeyError,TOOLS[tool]["fn"](**args) 这一段没有校验、没有 try、没有分类,返回时对字符串做截断但不说一句话。
guarded 线在五段上各加一道判断。核心是第 3 段——校验必须在执行之前。代码先取 schema,遍历 args 的每个字段:字段不在 schema 里就报"[validate] 工具.字段 不是它的参数,可用:{sorted(schema)}";再核对类型,特别要注意 Python 里 True 也是 int,必须显式挡掉布尔值,这就是 schema 要写全的原因。
动手做的重点不在写代码,在六组故障。每组只改一个变量。
六组故障与实测结果
六组故障的构造与预期观察如下:timeout 让工具自己睡 2 秒,观察有没有"预算"概念还是傻等;unknown_tool 调用清单里没有的 read_head,观察名字错在第几段被发现;bad_params 传 lines="three"(要整数),观察校验在不在执行之前;exec_throw 把一个目录当文件读,观察异常有没有被分类成人话;silent_truncate 让工具返回 20000 字,观察截断说不说;partial_write 写一行然后故意抛错,观察改了一半谁来撤。
运行后会先看到一行阳性对照:阳性对照 clean: naive=OK guarded=OK ⇒ 台架可用。它是防呆用的:干净调用两条线都必须拿到结果。如果这里出现 BAD,说明台架本身坏了,下面的数不许看——先修台架,再谈结论。任何机械判定的实验,第一行必须是阳性对照。
同一个服务,只换接法,实测结果如下:
| 故障 | naive | guarded |
|---|---|---|
| timeout | 等了 2.0 秒拿到结果(没有超时概念) | 0.5 秒放弃等待,拦在 transport |
| unknown_tool | KeyError 冲出链路 | 拦在 service,报出"最接近的是 head" |
| bad_params | TypeError 冲出链路(走到第 4 段) | 拦在 validate(走到第 2 段) |
| exec_throw | IsADirectoryError 冲出链路 | 拦在 exec,带工具名 + 参数回显 |
| silent_truncate | 2000 字,无标记 | 2025 字,带"已截断:共 20000 字" |
| partial_write | 文件真被写进去了,留下副作用 | 拦在 exec,已回滚,无副作用 |
三条要读出来的东西:
其一,naive 的 6 组没有一组是被"接住"的。它在四种情况下抛的是原生异常(KeyError、TypeError、IsADirectoryError、RuntimeError),这些异常会冲出调用栈,落到调用它的那层代码上。如果那层是模型在驱动的循环,它拿到的往往只是一句"工具调用失败"。按定位项统计,naive 五组是 0。
其二,guard 的拦截位置由故障类型决定,不是随便找个地方报错。名字错→service;类型错→validate;执行错→exec;超时→transport。这条对应关系本身就是价值:从错误文本的第一个方括号,就知道该去哪一段改。
其三,bad_params 那一行是"越靠前越便宜"的量化。同一个故障,guard 只让请求走到第 2 段,naive 走到了第 4 段——差的两段是"参数校验"和"工具真被执行"。在真实系统里,第 4 段的代价不是两段代码,而是"工具真的动了生产数据"。
再看错误文本,差别更直白:
naive   TypeError: list indices must be integers or slices, not str
guarded [validate] head.lines 类型不对: 要 int,给的是 str='three'
第二行同时回答了三个问题:错在哪一段(validate)、错在哪个工具的哪个字段(head.lines)、错成什么样(给了 'three')。第一行只回答了"Python 不高兴"。这就是"有人接住"和"有人负责"的差别。
为什么 MCP 只解决了前两段
这部分不重跑实验,直接引旧线的两组数。
第一组:谁拦得住越界读。8 个臂里,只有 E_guard_on——也就是执行器里那段路径校验打开的时候——把 6 次越界读全部挡住(0/6 读到)。其余六个有记录的臂全部 6/6 读到,包括这些:客户端诚实地声明了当前的项目根目录;客户端声明了一个假的根目录 file:///etc;客户端根本不支持 roots 这个能力(server 那边直接报 "List roots not supported")。
三行一起看,结论很硬:拦住越界的不是协议,是自己写的那个 startswith(ROOT)。协议把"声明根目录"的接口放在那儿了,但声明是声明,执行是执行,协议没有替调用方把判断做掉。
第二组:MCP 有没有顺手帮忙省上下文。同一个"读文件"任务,MCP 臂 20/20 成功,进主上下文的净载荷 10,544 字节,和直接读那一臂逐位相同;但协议加执行层的原始流量是 65,400 字节(直读那臂也是 10,544),墙钟 10.48 秒。翻译成人话:MCP 带来了协议开销,但一个字节的上下文都没省。省不省上下文是第 3、4 段的选择(要不要摘要、要不要截断、给多少),不是协议自带的功能。
把这两组数和五段拼起来,就是那句判断:MCP 标准化的是"怎么把工具递到模型面前",不是"工具坏了谁负责"。前两段已经站在别人的肩膀上;后三段站在空地上,而且没人提醒脚下是空的。
静默失败比报错更贵
silent_truncate 那一组最有说服力:naive 拿到 2000 字,肉眼完全看不出它是被截断的——它是一个合法的字符串,长度也对,挑不出毛病。
旧线还有一组更狠的数据:8 组臂里有 6 组是"往 stdout 里多打了点东西"(另两组是干净对照、stderr 对照),其中只有 2 组把调用真的打死了(half_line 半行、fake_id_match 假帧顶替),另外 4 组污染被客户端静默吞掉、调用照常返回——污染发生了,但没有任何渠道知道。而这 2 组打死调用的臂,报错文本里"能不能定位到污染源"这一项都是 false:一组是"等待 8.0 秒超时",另一组报的是客户端自己的校验错误。
两组合起来是一条经验:失败的可定位性,和失败本身同等重要。报错文本里如果只有"超时"和"ValidationError",接下来要做的是重新做一遍实验;如果里面有"哪一段、哪个工具、哪个字段、那个坏值",接下来要做的是改一个地方。这两种体验的差距,全在接住失败的那几行代码里。
三条能直接抄走的写法
其一,参数校验放在执行之前,而且报错要带字段名和那个坏值,别等工具自己抛错。一份 schema 声明(类型、必填、范围、长度)加一个循环,就能把第 4 段的代价挪到第 3 段。报错文本按这个顺序写:[段名] 工具.字段 错在哪:要什么,给的是什么。
其二,每个工具都要有个预算。超时不是"防慢"的保险,它是链路的一段:到点了就必须有一条明确的错误,而不是继续等。naive 那 2.0 秒很说明问题——它没有超时,只是等到了工具自己跑完,而真实世界的工具不会这么客气。
其三,有副作用的工具,先把"怎么撤销"记下来再动手,顺序不能反。执行前把当前状态存一份(哪怕只是一段文本),执行挂了就恢复,恢复不了至少要在报错里说清楚"可能留下了什么"。这一条在 partial_write 那组是唯一一次真实差别:naive 那一边文件真被改了、只能人工收拾,guard 那一边恢复原状。
顺带一条取舍:这五段不值得在所有工具上平均用力。一个只读的 head,第 5 段回滚可以直接不做,因为无状态可撤;一个会写文件、会发请求、会扣额度的工具,必须做。判断依据只有一条:这个工具失败之后,世界上有没有什么东西变了。没变,就省掉;变了,就不能省。
常见坑
把"有 try/except"当成"有人负责"。兜底很容易,一行 try: ... except Exception: return "失败" 就够。但这一轮里最有价值的一半结论恰恰是:接住之后能不能定位才是分水岭。一个不带分类和字段信息的"失败",只是把静默失败从工具挪到了链路里。
把超时设成一个"够大就行"的数。guard 的预算设成 0.5 秒,slow_head 睡了 2 秒,于是它被拦住了——但这个拦截给的是"预算",不是"确定性"。把预算放宽到 5 秒,同一组故障就不再被拦。超时的作用是把"无限等"变成"有上限地等",不是保证失败一定会被发现,别把它写成保证。
以为协议会兜住执行段。上面那 8 个臂已经说清楚:客户端可以声明根目录、也可以不支持根目录,越界读在两边都是 6/6。看到"协议里有这个字段"就等于"责任被标准化了",是这一步最贵的误判。
在测试里只验证"调用成功"。如果只看 success 这一个布尔值,6 组故障里 timeout 和 silent_truncate 两组都会被判成通过——一组真的成功但慢了四倍,一组成功但数据缺了十分之九。验收要落在"返回的形状"上:长度、有没有标记、耗时在不在预算内。
把台架的"传输"当成真网络。这份脚本里,传输段是一次同进程的线程调用加一次 JSON 往返,不是真 socket。这么做是为了让超时、截断、异常这三个自变量可控;真网络会多出一层连接错误、DNS、证书失败,但它们都落在第 1 段,五段的责任划分不变。要拿去量自己的链路,把传输段换成真实客户端即可,后面四段的判据都不用改。
把这张五段表当标准。它是一张归因表,不是一个协议分层。别的实现划成四段或六段都行,有用的是"出错时能指到唯一一段"这个性质,不是"必须是五"。
结语
工具接入的标准化只走了一半。MCP 把"怎么把工具递到模型面前"变成了公共协议,但"工具坏了谁负责"仍然落在链路的后三段,而这三段恰恰最容易出静默问题。参数校验、执行预算、回滚记录,这些职责在协议之外,只能由业务侧自己补上。
当一套 Agent 工作流要同时对接多个工具服务与模型后端时,链路治理会叠加到协议之上。Treerouter 作为 API 网关,可统一多后端场景下的鉴权、流量调度与用量记录,降低复杂工具链路的集成负担。五段归因表的价值不在分段本身,而在出错时能精准定位到唯一一段,把"接住失败"从一句空话变成可执行的工程动作。